
부스트캠프 AI Tech 3기, level1 CV 14조
-
프로젝트 주제 :
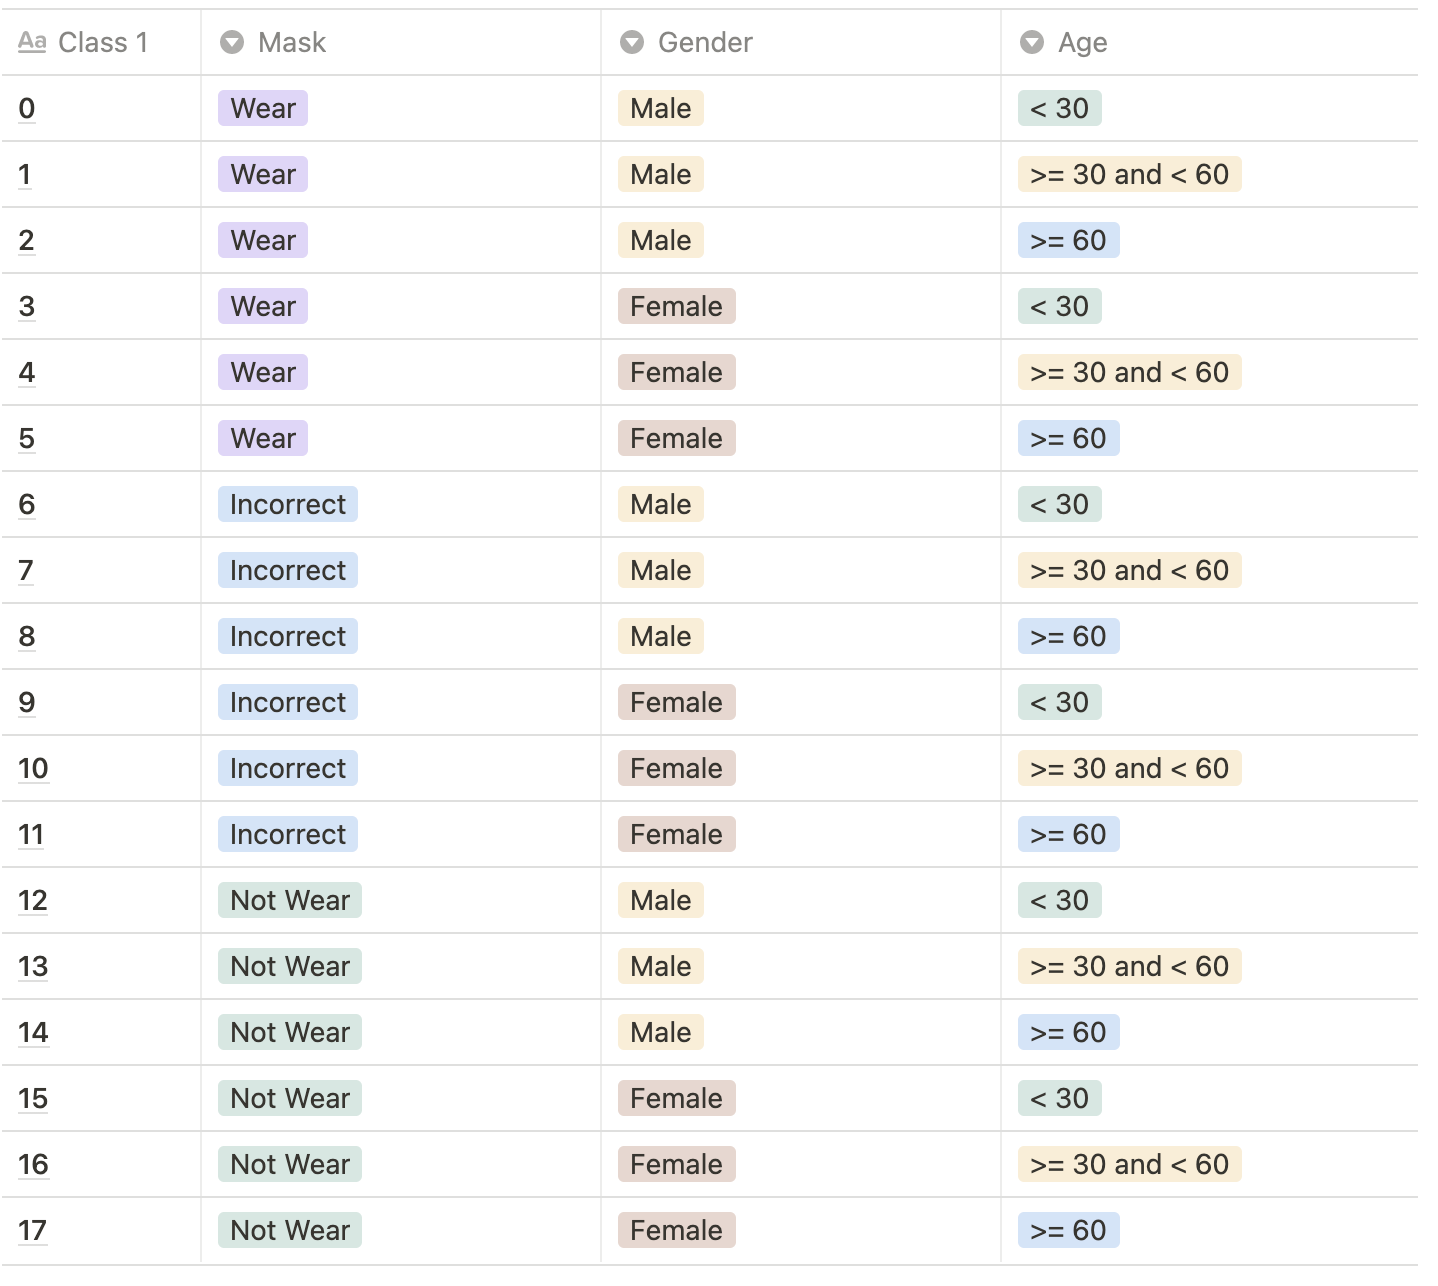
마스크 착용 상태 분류- 성별 (남/여)
- 나이 (
29 / 3059 / 60~) - 마스크 착용 상태 (미착용 / 정상 착용 / 비정상 착용)
→ 총 18개(2 x 3 x 3)의 클래스에 대한 예측.
-
개발 환경 및 협업 tool
Python,PyTorch,Tensorboard,VScode,github -
데이터 개요
-
전체 사람 수: 4,500명
-
한 사람 당 사진 개수: 7장 [마스크 착용 5장, 이상하게 착용(코스크, 턱스크 등) 1장, 미착용 1장]
-
학습 데이터 셋: 60% / 평가 데이터 셋: 40%
-
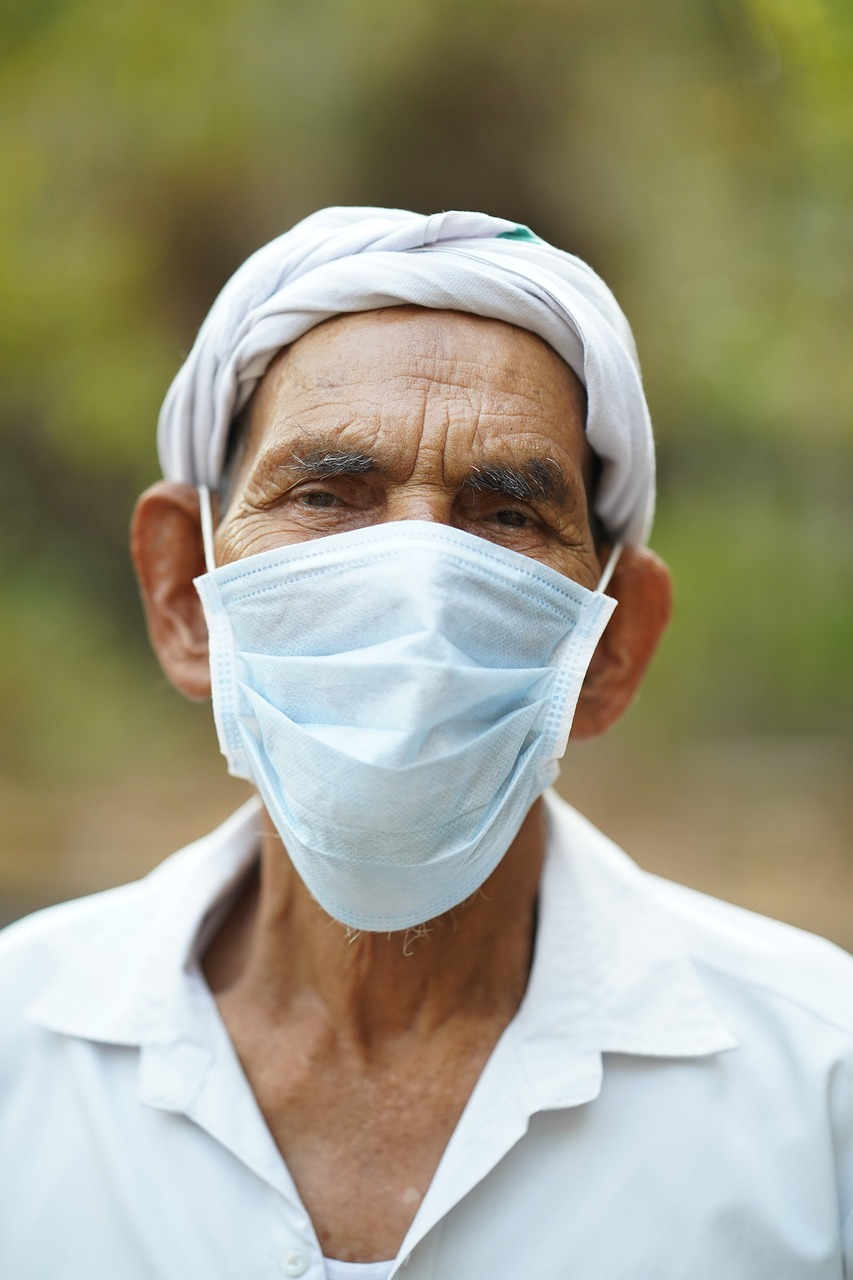
입력: 마스크 착용 사진, 미착용 사진, 혹은 이상하게 착용한 사진
-
출력: 총 18개의 클래스 (0~17)
예시
-
-
기대 효과
COVID-19은 감염자의 입, 호흡기로부터 나오는 비말, 침 등으로 인해 다른 사람에게 쉽게 전파가 될 수 있기 때문에, 감염확산 방지를 위해 마스크를 올바르게 착용하는 것이 중요하다. 따라서 우리는 카메라에 비춰진 사람 얼굴 이미지만으로 이 사람이 마스크를 올바르게 쓰고 있는지 자동으로 가려낼 수 있는 시스템이 갖춰진다면 적인 인적자원으로도 COVID-19의 확산방지에 도움이 될 것이다.
- 김찬민_T3060: 베이스라인 코드 이해
- 김준_T3054: 베이스 라인 코드 이해, 모델 및 loss 성능 비교, Data Augmentation 비교
- 조유진_T3208: 각각 학습한 여러 모델들을 연결.
- 최홍록_T3228: 모델 성능비교, Data Augmentation비교.
실제로 모델링을 처음 하기 때문에 모델을 검증하고 개선하는 경험이 필요하다고 판단했다.
그래서 이번 프로젝트의 목적은 개인의 프로젝트 이해와 모델링에 익숙해지는 것이었다.
- 각자 모델링 및 Data Augmentation, Optimizer 사용
- 각자 해본 Augmentation 기법, Scheduler등 여러가지 기법들 공유
- Git을 사용한 코드 공유
- 공유한 내용들 바탕으로 각자의 모델 개선
- 개선된 모델 중 좋은 성능을 보이는 모델 2개를 선정 및 결과 제출
- Oversampling과 Tomek Links를 사용한 Data Augmentation.
- Mix Up을 사용한 Data Augmentation.
- AMP를 사용한 학습 시간 단축.
- NNI를 사용한 하이퍼 파라미터 튜닝
- 데이터의 양이 적은 클래스를 Oversampling 하는 과정에서 Overfitting을 우려해 60세 이상의 이미지는 4배로 늘려주고 59세의 데이터를 60세로 바꾼 뒤 2배로 늘려줌.
- Mix Up을 사용할 때 일정 비율로 사용하지 않고 랜덤한 이미지와 랜덤한 비율로 데이터를 섞어서 써서 일반화가 잘 될 수 있게 함.
- ResNet18에서 Data Augmentation을 사용해 성능 향상.
- ResNet152로 모델의 크기를 키워서 성능 향상.
- NNI를 사용해 Loss Function 결정.
- Adam과 CosineAnnealingLR을 사용해 Local Minimum 탈출 도모.
- 마스크 착용 여부 예측 모델 : ResNet18 + Normalization
- ResNet18만으로 성능이 충분하다고 생각하여 특별히 개선 사항 없음.
- 성별, 나이 예측 모델 : GoogLeNet + CenterCrop + Normalization
- optimizer : Adam
- LR scheduler : CosineAnnealingLR
- 마스크 착용 여부에 따라 성별, 나이 예측 시 고려해야할 feature가 다르지 않을까 하여 모델을 분리.
- 60세 이상 데이터가 적은 것을 고려하여, 58~59세를 60세로 수정. & 60세의 데이터를 2배로 증가.
- train 시 배경보다 얼굴에 좀 더 집중할 수 있도록 CenterCrop 사용.
- 60세 이상의 데이터를 늘리니 미착용과 올바르지 않게 착용 시의 val acc. 향상.
- 60세 이상 데이터 증가만으로 최종 F1 score가 0.6918 → 0.7144로 향상.
- 모델 개요
- 단일 모델로 18개 클래스 예측하기.
- 마스크 착용 여부를 예측하는 모델과 성별, 나이를 예측하는 모델 분리하기.
- 모델 평가
- 주어진 학습 데이터를 사람 별로 train set / validation set으로 나눈 뒤 사용.
- 시연 결과
- Pretrained ResNet152
F1 Score : 0.7370Accuracy : 80.0317- 결론 : 처음에는 데이터의 불균형이 심해서 모델이 크든 작든 성능이 비슷했다. 하지만 Augmentation으로 데이터의 불균형을 해소한 후 큰 모델을 사용해보니까 모델이 크면 클수록 성능이 잘 나오는 것을 확인 할 수 있었다. MixUp을 통해 계속 새로운 이미지가 입력값으로 사용 되는 효과를 기대할 수 있는데 이렇게 되면 ResNet152보다 더 큰 모델을 사용했을때 학습을 시키면 시킬수록 더 잘 학습이 될 것이라는 것을 기대할 수 있다.
- ResNet18 + GoogLeNet (모델 분리)
F1 Score : 0.7144Accuracy : 76.1905- 결론 : 모델 3~4개를 따로 학습시켜야 해서 시간이 오래 걸림. 때문에 ResNet18과 GoogLeNet에서만 시도를 하여 유의미한 성능 향상을 얻지 못 함. 별 다른 parameter 변경 없이 데이터 불균형만 살짝 조정하여 꽤나 유의미한 f1 score 향상을 얻음. 데이터 불균형 조정 후에는 큰 모델일수록 학습이 잘 되는 위 실험 결과를 고려하면, 데이터를 좀 더 조정하고 큰 모델을 사용하면 더 많은 성능 향상을 기대해볼 수 있을 것 같다.
- Pretrained ResNet152
- 잘한 점
- github**을 활용한 코드공유가 잘 이루어졌다.
- 모듈화된 코드를 이해하고 command line에서 활용하였다.
- tmux, tensorboatd, nii 등의 툴들을 활용했다.
- 아쉬운 점
- 협업이 잘 이루어지지 않았다.
- LB 상에서 성능이 좋지 않았다.
- 배경을 지우는 Transform을 적용했다면 더 좋은 성능을 얻을 수 있었을 것이다.
- 시도 했으나 잘 되지 않았던 것
- Data Imbalance 해결
- Overfitting 문제 해결
- 데이터 resize 및 crop을 통해 학습데이터의 multi-scaling 시도